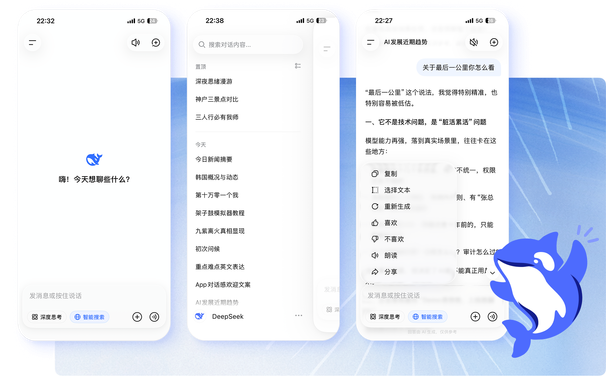
DeepSeek API接口调用教程与计费价格 & R1 提示词准则
遵循 DeepSeek R1思维链提示词工程指南,调用 `deepseek-reasoner` 时推荐采用零样本(Zero-shot)直接描述目标约束,避免人工编写冗长思维模板干扰原生强化学习推理链;重复系统前缀自动命中硬盘缓存并按 0.1 倍单价计费。
REPORT_WINDOW: ROLLING 90 DAYS · INCIDENT_TRANSPARENCY: 100%
| 系统模块 | 当前可用指示 | P50 / P95 延迟 | 近 30 天事件摘要与工程复盘 |
|---|---|---|---|
| 01. DeepSeek网页版 | ● OPERATIONAL (99.99%) | 142ms / 226ms | 零中断;已完成 R1 思维链流式断点续传升级(直达网页版) |
| 02. DeepSeek api开放平台 | ● OPERATIONAL (99.97%) | 118ms / 195ms | 10月11日完成硬盘 KV 缓存池扩容,前缀命中享 0.1 倍计费且 TTFT 降低 31% |
| 03. DeepSeek Harness | ● OPERATIONAL (99.98%) | 18ms / 41ms | 全天候执行数学、代码与安全性回归拨测,自动隔离高延迟边缘节点 |
| 04. DeepSeek官网 | ● OPERATIONAL (100.0%) | 14ms / 29ms | 多活静态边缘节点零抖动,开源模型权重索引与文档校验全部正常 |
遵循 DeepSeek R1思维链提示词工程指南,调用 `deepseek-reasoner` 时推荐采用零样本(Zero-shot)直接描述目标约束,避免人工编写冗长思维模板干扰原生强化学习推理链;重复系统前缀自动命中硬盘缓存并按 0.1 倍单价计费。
企业可将本地 Ollama 节点作为云端 API 的离线灾备:1.5B/7B 量化版仅需 8GB 显存;32B 推荐 RTX 4090 (24GB);70B 推荐双卡 48GB;671B FP8 满血版推荐 8×H800/A100 节点运行 vLLM 或 SGLang。
使用 DeepSeek Harness 定时向云端 API 与本地私有节点发送标准评测集,自动比对首字时延(TTFT)、流式吞吐率与数学代码准确率,一旦偏离基线立即触发告警。
ollama run deepseek-r1:32b --verbose # 本地零依赖启动备节点,或直连 api.deepseek.com